検索で次に何を試すかをどう決めているか:書き留めた予測のキュー
私たちの検索のロードマップは仮説のキューです。各仮説には、測定前に書き留めた予測と、それを反証する結果が付いています。ひとつの数字がどうキューを並べたか、そして最初の賭けが外れたとき、キューがどう自ら並び替わったか。
検索システムが動くようになると、試せることのリストは長くなります。リランカー、 より良い埋め込みモデル、チャンキング、クエリの書き換え、ステミング、融合の 調整。どれにも「うちでは効いた」という記事があります。難しいのはアイデアを 見つけることではありません。順番を決めること、そしてひとつのアイデアを信じるのを いつやめるかを知ることです。
コーディングエージェントにコンテキストを提供するナレッジシステム「Cortex」では、 そのリストを仮説のキューとして管理しています。この記事では、そのキューの 仕組みを説明します。エントリーに何が入るか、何が順番を決めるか、そしてエントリーが 誤りだと証明されたら何が起きるか。数字の裏にあるベンチマークについては 検索(リトリーバル)をどう評価しているか に書いています。
エントリーはタスクではなく実験
「リランカーを追加する」はタスクです。コードがマージされれば完了で、間違う余地は ありません。キューのエントリーは、代わりに4つの部分でできています。
- 仮説。理由を添えて、一文で。
- 予測。どの指標がどれだけ動くか、そしてどの指標は動いてはいけないか。
- 何がそれを反証するか。気分ではなく、しきい値として書く。
- 反証されたらキューがどうなるか。どのエントリーが繰り上がるかを、誰も守りたい 結果を持っていない今のうちに決めておく。
予測は、最初の測定が走る前にリポジトリにコミットします。コミット履歴がその証拠です。 予測のファイルは、結果のファイルよりも前のタイムスタンプを持っています。数字を 見てから予測を書くのは研究ではなく、語りです。
ひとつの数字が順番を決めた
私たちのベンチマークには433件の実際のクエリがあり、それぞれにエージェントが タスクに役立つと判定した文書が付いています。判断に使う構成で、次のように 測れました。
| 指標 | 値 |
|---|---|
| recall@5 | 0.233 |
| recall@24 | 0.473 |
recall@kは、有用な文書のうち上位k件に現れるものの割合です。
コンテキストは24件のウィンドウとして提供されますが、エージェントが注意を向けるのは 上位5件です。24件での再現率は、5件での再現率のおよそ2倍でした。素直に読めば、 有用なものの半分はすでに見つかっていて、低すぎる位置にある、ということです。 これは「見つける」問題ではなく「並べる」問題を表しています。
この読みひとつで、キュー全体の順番が決まりました。並べる問題のための手法は クロスエンコーダーのリランカーで、クエリと各候補を一緒に読んでウィンドウを 並べ替えます。これが最初になりました。埋め込みモデルの変更は、意図して最後に しました。ハイブリッド検索の各側を別々にオフにしてみると、埋め込み側は深さを 加えていたものの、上位5件には測れるほどの寄与がなかったからです。より良い モデルは、いちばん高くつき、いちばん根拠の薄い実験でした。
その日に書かれたキューはこうです。
| # | 仮説 | 攻めるもの | コスト |
|---|---|---|---|
| 1 | 上位24件へのクロスエンコーダーによるリランク | 順番 | 中 |
| 2 | スペイン語のステミング(今はpropuesta ≠ propuestas) |
何が見つかるか | 低 |
| 3 | 長い文書のチャンキング | 何が見つかるか | 低 |
| 4 | LLMによるクエリ拡張 | 何が見つかるか | 中 |
| 5 | 別の埋め込みモデル | 何が見つかるか | 高 |
| 6 | 融合の定数と重みのスイープ | 順番 | 低 |
いちばん大事なのは「攻めるもの」の列です。リストの手法はどれも、ウィンドウに どの文書が入るかを変えるか、その中の順番を変えるかのどちらかです。数字は、 私たちが抱えているのがどちらの問題かを教えてくれた。だから、リストのどちらの 半分から始めるべきかも教えてくれました。
最初のエントリー、書かれたとおりに
リランカーの予測ファイルには、実行前にこう書かれていました。
- recall@24はまったく動かない。 リランカーは、誰がウィンドウにいるかを変えずに 並べ替えるだけです。この数字が動いたら実験の配線が間違っていて、その実行の ほかの結果はすべて無効です。これは結果ではなく健全性チェックです。
- recall@5は0.233から0.34へ上がり、対応のある95%信頼区間はゼロをまたがない。 これが判断を決める数字です。
- MRRとnDCG@10はそれぞれ約0.30と0.29に上がる。
- 本当のコストはレイテンシで、すべての指標が有利でも、デフォルトでオフの フラグの後ろで出す。
- 反証条件:recall@5の上昇が0.05未満、または区間がゼロをまたぐ。その場合、 「良い文書は見つかっているが並びが悪い」という前提は誤りか不十分であり、 何が見つかるかを攻めるエントリー2と4が繰り上がる。
測定が示したこと
同じ日、同じコーパス、同じ433件のクエリを、クエリごとに比較しました。
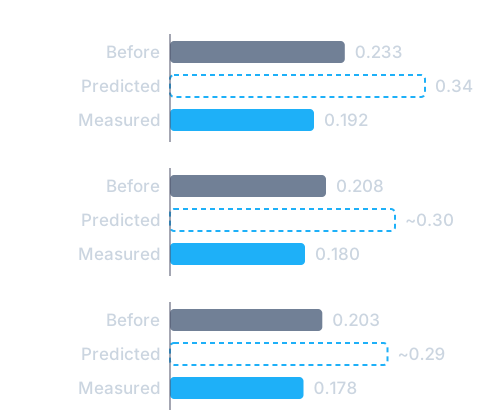
| 指標 | 前 | リランカーあり | 差 | 95%区間 |
|---|---|---|---|---|
| recall@5 | 0.233 | 0.192 | −0.041 | −0.070〜−0.011 |
| MRR | 0.208 | 0.180 | −0.028 | −0.048〜−0.007 |
| nDCG@10 | 0.203 | 0.178 | −0.025 | −0.044〜−0.007 |
| recall@24 | 0.473 | 0.473 | 0.000 | 同一 |
健全性チェックは持ちこたえました。recall@24は動かず、実行は有効でした。判断を 決める指標は逆方向に動き、区間はその低下が本物だと言っています。さらに1クエリ あたりの時間は0.3秒から約6.9秒になりました。
このエントリーは偽として閉じられました。次に何をするかで議論する必要は ありませんでした。予測ファイルがすでにそう書いていたからです。ステミングと クエリ拡張が繰り上がり、リランカーのコードはテストと測定結果を添えて、オフの 状態でリポジトリに残しました。後で誰かが「当然の解決策」だと思って作り直さない ためです。
エントリーが負けると、キューが良くなる理由
反証されたエントリーは、確認されたエントリーが残さないものを残します。前よりも 鋭い、新しい問いです。リランカーの結果について、私たちのいちばん有力な説明は、 私たちのラベルが意味するのはタスクに役立つであってクエリに似ているではなく、 汎用のリランカーは後者で訓練されている、というものです。この説明はまだ検証されて いないので、それ自体がひとつのエントリーとしてキューに入りました。安く試せます。 同じリランカーに、生の文書ではなく、インデックスが見ているのと同じ拡張済みの テキストを読ませるのです。それでも負けるなら、発見はどのリランカーよりも大きな ものになります。このコーパスでは、類似度で並べることには天井があり、効くのは 判定から学ぶことだ、ということです。すでにそちらに傾くデータがひとつあります。 過去に役立った文書のランクを上げる構成は、そうしない構成よりrecall@5が+0.056 高いのです。
これが、私たちがロードマップに求める振る舞いです。タスクのリストは増えるだけです。 予測のキューは自分の結果で並び替わり、結果が出るたびに、次の実験が答えるべき ことが絞られていきます。
自分でも持ちたいなら
- 並べる前に測る。 リストを2つに分けるひとつの読みを見つけてください。私たちに とってはrecall@24対recall@5、つまり「見つかっているが低い」対「見つかって いない」でした。あなたのものは違うかもしれません。大事なのは、好みではなく数字が リストを並べることです。
- 各アイデアに、何を攻めるかのタグを付ける。 順番か、何が見つかるか。横にコストを 書いておけば、根拠の薄い高価なアイデアは自然に沈みます。
- 実行前に反証のしきい値を書く。 「上昇が0.05未満、または区間がゼロをまたぐ」は しきい値です。「あまり効かない」はしきい値ではありません。
- 並び替えを前もって書く。 次に何をするかの判断は、誰かが本当であってほしい 結果を手にする前がいちばん安く済みます。
- 動いてはいけない指標をひとつ入れる。 悪いアイデアと壊れた実験を見分ける、 唯一の方法です。
- 測定中にコーパスを変えない。 私たちの2回の実行の間に、ナレッジベースに文書が 1件承認されました。測定中の変更についてのメモです。ベンチマークがそれを検知し、 私たちは両側を続けて走らせ直しました。学習するシステムと、テスト対象のシステムは、 同じシステムだったのです。
これらの数字の出どころ
予測、実行、クエリごとの結果は私たちのリポジトリにあります。予測ファイルは測定より 前にコミットされ、各実行はコーパスのフィンガープリントとともに保存されているので、 区間を再計算できます。ほかの検索に関する記事と同じ限界があります。コーパスは ひとつで、識別子が多く、ラベルは「似ている」ではなく「役立つ」を意味します。 キューの中身はあなたのデータでは違うものになるでしょう。方法は違わないはずです。