Cómo decidimos qué probar después en el retrieval: una cola de predicciones escritas
Nuestra hoja de ruta de retrieval es una cola de hipótesis, cada una con su predicción y el resultado que la refutaría escritos antes de medir. Cómo un número ordenó la cola, y cómo la cola se reordenó sola cuando perdió la primera apuesta.
Una vez que un sistema de retrieval funciona, la lista de cosas que se podrían probar es larga: rerankers, un mejor modelo de embeddings, chunking, reescritura de consultas, stemming, ajustar la fusión. Cada una tiene un artículo que dice que a alguien le sirvió. Lo difícil no es encontrar ideas. Es elegir el orden, y saber cuándo dejar de creer en una.
Para Cortex, el sistema de conocimiento que les sirve contexto a nuestros agentes de código, llevamos esa lista como una cola de hipótesis. Este artículo cuenta cómo funciona: qué lleva una entrada, qué decide el orden y qué pasa cuando se demuestra que una entrada estaba equivocada. El banco de pruebas detrás de los números está descrito en Cómo evaluamos el retrieval.
Una entrada es un experimento, no una tarea
"Agregar un reranker" es una tarea. Está hecha cuando se mergea el código, y nada de ella puede estar equivocado. Una entrada de la cola, en cambio, tiene cuatro partes:
- La hipótesis, en una oración, con la razón detrás.
- La predicción: qué métrica se mueve, cuánto, y qué métricas no se tienen que mover.
- Qué la refutaría, escrito como un umbral, no como un estado de ánimo.
- Qué le pasa a la cola si se refuta: qué entradas suben, decidido ahora, mientras nadie tiene un resultado que defender.
La predicción se commitea al repositorio antes de que corra la primera medición. El historial de commits es la prueba: el archivo con la predicción tiene una fecha anterior al archivo con el resultado. Escribir la predicción después de ver el número no es investigación; es narración.
Un número decidió el orden
Nuestro banco tiene 433 consultas reales, cada una con los documentos que un agente marcó como útiles para su tarea. Sobre la configuración que usamos para decidir, midió:
| métrica | valor |
|---|---|
| recall@5 | 0,233 |
| recall@24 | 0,473 |
recall@k es la proporción de documentos útiles que aparecen en los primeros k resultados.
El contexto se sirve como una ventana de 24 resultados, pero el top 5 es donde un agente presta atención. El recall en 24 era aproximadamente el doble del recall en 5. Dicho sin vueltas: la mitad de lo útil ya se estaba encontrando, y estaba demasiado abajo. Eso describe un problema de orden, no un problema de encontrar.
Esa sola lectura ordenó toda la cola. La técnica hecha para problemas de orden es un reranker cross-encoder, que lee la consulta y cada candidato juntos y reordena la ventana. Fue primero. Cambiar el modelo de embeddings quedó último a propósito: cuando apagamos por separado cada lado de nuestra búsqueda híbrida, el lado de embeddings sumaba profundidad pero nada medible en el top 5, así que un modelo mejor era el experimento más caro con menos evidencia detrás.
La cola, como quedó escrita ese día:
| # | hipótesis | ataca | costo |
|---|---|---|---|
| 1 | Reranker cross-encoder sobre el top 24 | el orden | medio |
| 2 | Stemming en español (hoy propuesta ≠ propuestas) |
qué se encuentra | bajo |
| 3 | Chunking de documentos largos | qué se encuentra | bajo |
| 4 | Expansión de consultas con un LLM | qué se encuentra | medio |
| 5 | Otro modelo de embeddings | qué se encuentra | alto |
| 6 | Barrer la constante y los pesos de la fusión | el orden | bajo |
La columna que más importa es ataca. Cada técnica de la lista o cambia qué documentos entran en la ventana o cambia el orden dentro de ella. El número nos dijo cuál de los dos problemas teníamos, así que nos dijo por qué mitad de la lista empezar.
La primera entrada, como se escribió
El archivo de predicción del reranker decía, antes de cualquier corrida:
- recall@24 no se mueve en absoluto. Un reranker reordena la ventana sin cambiar quién está adentro. Si este número se mueve, el experimento está mal cableado y nada más de la corrida cuenta. Es un control de cordura, no un resultado.
- recall@5 pasa de 0,233 a 0,34, con un intervalo de confianza pareado del 95 % que no cruza el cero. Este es el número que decide.
- MRR y nDCG@10 suben a alrededor de 0,30 y 0,29.
- La latencia es el costo real, y aun con todas las métricas a favor, sale detrás de un flag apagado por defecto.
- Refutada si recall@5 sube menos de 0,05 o su intervalo cruza el cero. En ese caso la premisa "los documentos buenos se encuentran pero se ordenan mal" es falsa o insuficiente, y suben las entradas 2 y 4, que atacan qué se encuentra.
Qué dijo la medición
Mismo día, mismo corpus, las mismas 433 consultas, comparadas consulta por consulta:
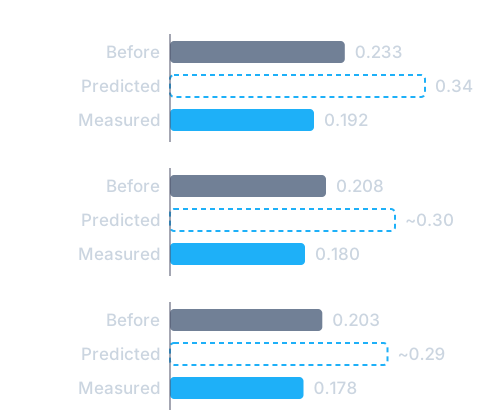
| métrica | antes | con reranker | diferencia | intervalo 95 % |
|---|---|---|---|---|
| recall@5 | 0,233 | 0,192 | −0,041 | −0,070 a −0,011 |
| MRR | 0,208 | 0,180 | −0,028 | −0,048 a −0,007 |
| nDCG@10 | 0,203 | 0,178 | −0,025 | −0,044 a −0,007 |
| recall@24 | 0,473 | 0,473 | 0,000 | idéntico |
El control de cordura se sostuvo: recall@24 no se movió, así que la corrida era válida. La métrica que decide se movió para el lado equivocado, y el intervalo dice que la caída es real. Cada consulta además tardó unos 6,9 segundos en vez de 0,3.
La entrada se cerró como falsa. Nadie tuvo que discutir qué seguía: el archivo de predicción ya lo había dicho. Subieron el stemming y la expansión de consultas, y el código del reranker quedó en el repositorio apagado, con sus tests y su medición al lado, para que nadie lo reconstruya más adelante creyendo que es el arreglo obvio.
Por qué la cola mejora cuando una entrada pierde
Una entrada refutada deja algo que una confirmada no deja: una pregunta nueva, más afilada que la anterior. Nuestra mejor explicación del resultado del reranker es que nuestras etiquetas significan útil para la tarea, no parecido a la consulta, y un reranker genérico está entrenado en lo segundo. Esa explicación todavía no está verificada, así que entró a la cola como una entrada propia, barata de probar: el mismo reranker, leyendo el mismo texto enriquecido que ve el índice en vez del documento crudo. Si igual pierde, el hallazgo es más grande que cualquier reranker: en este corpus, ordenar por similitud tiene un techo, y lo que rinde es aprender de los juicios. Un dato ya apunta hacia ahí: la configuración que sube a los documentos que ayudaron antes saca +0,056 de recall@5 sobre la que no lo hace.
Ese es el comportamiento que queremos de una hoja de ruta. Una lista de tareas sólo crece. Una cola de predicciones se reordena con sus propios resultados, y cada resultado achica lo que el próximo experimento tiene que contestar.
Si quieres llevar una
- Mide antes de ordenar. Encuentra la lectura que parte tu lista en dos. Para nosotros fue recall@24 contra recall@5: encontrado-pero-abajo contra no encontrado. La tuya puede ser otra; lo que importa es que un número ordene la lista, no una preferencia.
- Etiqueta cada idea con lo que ataca. El orden o qué se encuentra. El costo va al lado, así una idea cara con poca evidencia se hunde sola.
- Escribe el umbral que la refuta antes de correr. "Sube menos de 0,05, o el intervalo cruza el cero" es un umbral. "No ayuda mucho" no lo es.
- Escribe el reordenamiento por adelantado. La decisión sobre qué sigue es más barata antes de que alguien tenga un resultado que le gustaría que fuera cierto.
- Incluye una métrica que no se tiene que mover. Es la única forma de distinguir una mala idea de un experimento roto.
- No cambies el corpus mientras mides. Entre dos de nuestras corridas se aprobó un documento en la base de conocimiento: la nota sobre el cambio que se estaba midiendo. El banco lo marcó y corrimos los dos lados de nuevo, uno detrás del otro. El sistema que aprende y el sistema bajo prueba eran el mismo sistema.
De dónde salen estos números
La predicción, las corridas y los resultados por consulta viven en nuestro repositorio: el archivo de predicción se commiteó antes de la medición, y cada corrida se guarda con la huella de su corpus para que los intervalos se puedan recalcular. Valen los mismos límites que en nuestros otros artículos de retrieval: un corpus, cargado de identificadores, con etiquetas que significan útil y no parecido. La cola te va a salir distinta con tus datos. El método no debería.