Cuánto silencio deja cada modelo de voz de ElevenLabs en español
Medimos la misma frase con tres voces y tres modelos de ElevenLabs. Una tabla con los segundos de silencio interno de cada combinación, para elegir con un número.
También en: English
Elegir una voz sintética suele ser cosa de oído. El silencio que mete cada modelo entre frases, en cambio, se puede medir.
Si la usas en un video, ese silencio importa: cada pausa de más alarga la pieza y le quita ritmo. Por eso medimos la misma frase, con tres cortes naturales, en tres voces y tres modelos de ElevenLabs.
La tabla
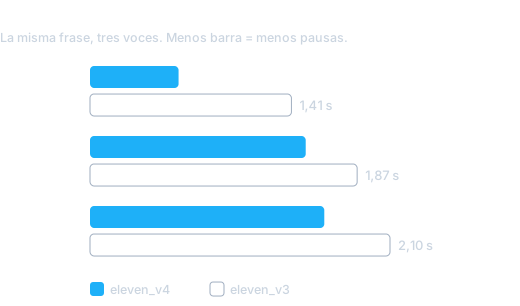
Segundos de silencio interno en la misma frase. Menos es más seguido.
| Voz | eleven_v4 | eleven_v3 |
|---|---|---|
| Sarah | 0,62 s | 1,41 s |
| Matilda | 1,51 s | 1,87 s |
| Chris | 1,64 s | 2,10 s |
eleven_v4 deja menos silencio que eleven_v3 en las tres voces. La diferencia
más grande es la de Sarah: de 1,41 a 0,62 s.
El tercer modelo, multilingual_v2, fue el peor en Sarah: metió 7 pausas dentro
de la misma frase.
Qué pasa en una pieza entera
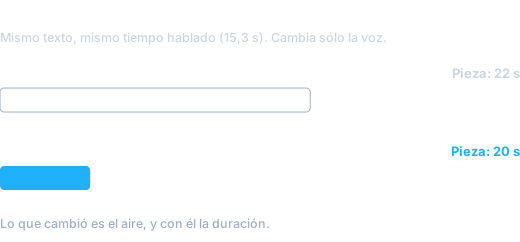
Una frase suelta es poco. Armamos una pieza de dos escenas con el mismo tiempo hablado, 15,3 s, y cambiamos solo la voz:
| Voz de OpenAI (ash) | Sarah con eleven_v4 | |
|---|---|---|
| Aire total | 2,82 s | 0,82 s |
| Duración de la pieza | 22 s | 20 s |
Mismo texto y mismo tiempo hablado: lo que cambió fue el aire, y con él la duración.
Cómo usar este número
- Mide con tu propia frase. Una con varios cortes naturales muestra mejor las diferencias entre modelos.
- Compara el silencio interno, no solo cuánto "suena bien".
- Si el video es público, revisa la licencia: el uso comercial de ElevenLabs pide un plan pago.
Una aclaración: es una medición propia, sobre una frase y una pieza. Sirve para elegir con un número en la mano, no es un benchmark general de las voces.
¿Tienes un caso donde quieres ver esto andando? Cuéntanos qué hace tu negocio y lo armamos sobre tu propio material.